



본문 중간의 쿠팡 추천 상품 구매시 쿠팡 파트너스에서 일정액의 수수료를 제공받습니다.
PostgreSQL pipeline mode는 libpq 클라이언트가 앞선 쿼리의 결과를 모두 읽기 전에 다음 쿼리를 보낼 수 있게 하는 기능입니다. 네트워크 왕복 지연이 큰 환경에서 작은 SQL을 여러 번 실행해야 할 때 대기 시간을 줄이는 데 목적이 있습니다.
기준은 명확합니다. 서로 독립적인 작은 INSERT, UPDATE, DELETE를 짧은 시간에 많이 보내고, 각 요청의 결과를 순서대로 매칭할 수 있다면 pipeline mode를 검토할 만합니다. 반대로 앞 쿼리 결과로 다음 쿼리를 만들어야 하거나, COPY처럼 pipeline mode에서 허용되지 않는 작업이 핵심이라면 다른 방식을 먼저 봐야 합니다.
pipeline mode가 줄이는 비용
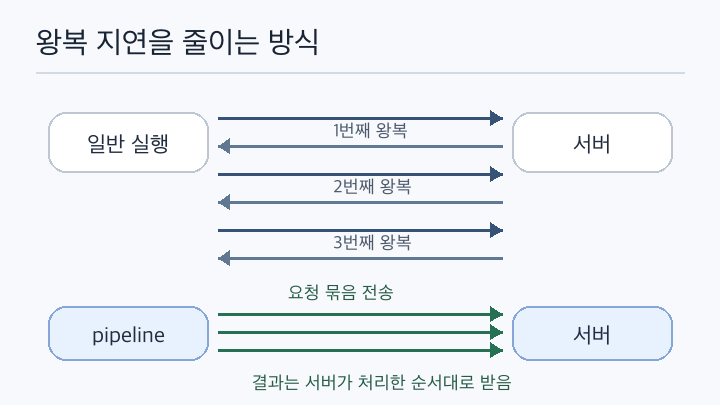
PostgreSQL 공식 문서에 따르면 libpq pipeline mode는 이전 쿼리 결과를 읽기 전에 다음 쿼리를 보낼 수 있게 합니다. 여러 요청과 결과가 하나의 네트워크 흐름 안에서 오가므로, 클라이언트가 서버 응답을 기다리느라 멈추는 시간이 줄어듭니다.
이 기능은 서버의 SQL 실행 시간을 없애는 기능이 아닙니다. 쿼리 자체가 오래 걸린다면 pipeline mode의 이득은 제한적입니다. 효과가 커지는 경우는 각 SQL은 짧지만 클라이언트와 서버 사이의 왕복 시간이 큰 경우입니다.
| 상황 | pipeline mode 판단 | 이유 |
|---|---|---|
| 원격 DB에 작은 변경 SQL을 반복 실행 | 검토할 만함 | 왕복 대기 시간이 누적되기 쉽다. |
| 각 쿼리가 오래 실행됨 | 이득이 작을 수 있음 | 네트워크보다 서버 실행 시간이 병목일 수 있다. |
| 앞 결과로 다음 쿼리를 결정 | 맞지 않는 경우가 많음 | 중간 결과를 기다려야 하므로 pipeline 장점이 줄어든다. |
| 대량 적재가 목적 | COPY 먼저 검토 |
pipeline mode에서는 COPY가 허용되지 않는다. |
어떤 API 흐름을 쓰나
pipeline mode는 libpq의 비동기 실행 모델 위에서 사용합니다. 연결이 idle 상태일 때 PQenterPipelineMode로 모드를 켜고, PQsendQueryParams 또는 PQsendQueryPrepared 같은 extended query protocol 기반 함수를 사용해 요청을 보냅니다.
공식 문서는 pipeline mode에서 synchronous command execution 함수인 PQexec, PQexecParams, PQprepare, PQexecPrepared 등을 쓰는 것이 오류 조건이라고 설명합니다. PQsendQuery도 simple query protocol을 사용하므로 허용되지 않습니다.
/* 흐름 예시: 실제 오류 처리는 생략 */
PQenterPipelineMode(conn);

PQsendQueryParams(conn, sql1, 0, NULL, NULL, NULL, NULL, 0);
PQsendQueryParams(conn, sql2, 0, NULL, NULL, NULL, NULL, 0);
PQpipelineSync(conn);

while ((res = PQgetResult(conn)) != NULL) {
  /* 보낸 순서에 맞춰 결과를 처리 */
}

PQexitPipelineMode(conn);PQpipelineSync는 pipeline 안에 동기화 지점을 표시하고 send buffer를 flush합니다. 결과 처리를 모두 끝내고 pipeline 끝 결과까지 소비한 뒤에야 PQexitPipelineMode로 일반 모드로 돌아갈 수 있습니다.
큐 관리가 핵심이다
pipeline mode는 단순히 SQL을 여러 개 붙여 보내는 기능이 아닙니다. 클라이언트는 아직 보내지 않은 작업 큐와, 보냈지만 결과를 처리하지 않은 작업 큐를 관리해야 합니다. 서버는 클라이언트가 보낸 순서대로 명령을 실행하고 결과를 반환하므로, 애플리케이션도 그 순서에 맞춰 결과를 해석해야 합니다.
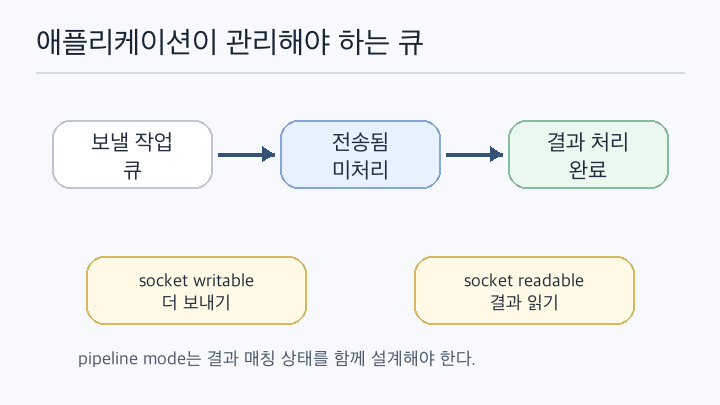
PostgreSQL 문서는 큰 pipeline에서 deadlock을 피하려면 non-blocking event loop 구조를 권장합니다. socket이 writable이면 더 보내고, readable이면 결과를 읽어 pending result queue와 맞추는 방식입니다. 결과를 pipeline 끝까지 기다렸다가 한꺼번에 읽을 필요는 없으며, 메모리 사용량을 고려해 자주 읽는 편이 낫습니다.
오류와 commit 판단 기준
pipeline mode에서는 오류도 비동기적으로 도착합니다. 공식 문서는 클라이언트가 COMMIT을 보냈다는 사실만으로 작업이 커밋됐다고 가정하면 안 되며, 해당 결과를 받아 커밋 완료를 확인해야 한다고 설명합니다.
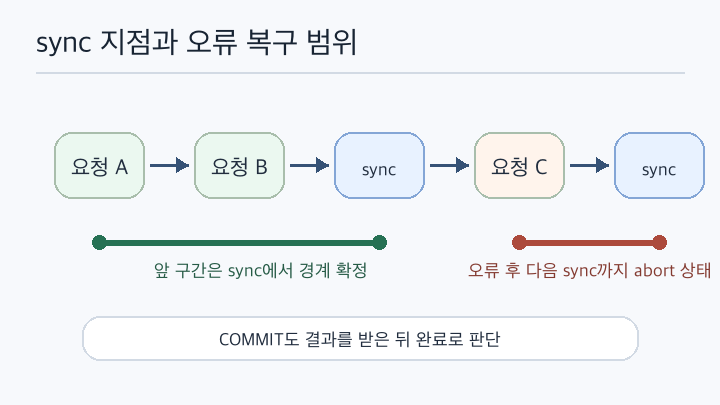
pipeline 중 오류가 발생하면 현재 pipeline은 aborted 상태가 될 수 있습니다. PQpipelineStatus는 PQ_PIPELINE_ON, PQ_PIPELINE_OFF, PQ_PIPELINE_ABORTED 같은 상태를 반환합니다. aborted 상태는 PQgetResult가 PGRES_PIPELINE_SYNC 타입의 결과를 반환할 때 해제됩니다.
따라서 pipeline은 논리적인 작업 단위로 나누는 편이 안전합니다. 보통은 하나의 transaction을 하나의 pipeline 구간으로 생각하면 오류 복구 경계를 이해하기 쉽습니다. 여러 transaction을 하나의 pipeline에 섞으면 성능 이득은 있을 수 있지만, 실패 시 어떤 작업을 다시 보내야 하는지 판단이 더 어려워집니다.
지원 조건과 제한
libpq pipeline API는 PostgreSQL 14에서 도입됐습니다. 공식 문서는 이것이 클라이언트 측 기능이며, v3 extended query protocol을 지원하는 서버라면 별도의 서버 측 pipeline 기능이 필요하지 않다고 설명합니다.
| 항목 | 기준 |
|---|---|
| 클라이언트 라이브러리 | pipeline API를 제공하는 libpq가 필요하다. |
| 실행 함수 | PQsendQueryParams, PQsendQueryPrepared 등 비동기 extended query 함수를 쓴다. |
| 금지되는 흐름 | PQexec 계열 동기 실행 함수, PQsendQuery, command string 안의 다중 SQL, COPY는 피한다. |
| 권장 구조 | non-blocking 연결과 event loop 기반 송수신 처리가 적합하다. |
| 비용 | 클라이언트와 서버 모두에서 pending 상태가 길어져 메모리 사용량이 늘 수 있다. |
실무 선택 기준
첫 번째 기준은 round-trip time입니다. 같은 데이터센터 안의 짧은 연결보다, 지리적으로 떨어진 클라이언트와 DB 사이에서 작은 작업을 반복할 때 pipeline mode의 의미가 커집니다.
두 번째 기준은 의존성입니다. 다음 SQL을 만들기 위해 앞 결과가 꼭 필요하다면 pipeline 구간을 길게 잡기 어렵습니다. 이런 경우에는 클라이언트에서 read-modify-write를 반복하기보다, 가능한 한 서버 쪽 SQL 하나로 상태 변경을 표현하는 편이 더 단순할 수 있습니다.
세 번째 기준은 운영 복잡도입니다. pipeline mode를 쓰면 결과 순서 매칭, sync 지점, 오류 후 재시도 범위, 메모리 사용량을 코드가 책임져야 합니다. 단순한 배치 입력이라면 COPY나 set-based SQL이 먼저이고, libpq 기반 클라이언트에서 작은 독립 작업을 지연 없이 밀어 넣어야 할 때 pipeline mode가 후보가 됩니다.
FAQ
pipeline mode는 prepared statement와 같이 쓸 수 있나?
가능합니다. 공식 문서는 PQsendQueryPrepared뿐 아니라 PQsendPrepare, PQsendDescribePrepared 같은 함수도 pipeline mode에서 동작한다고 설명합니다. 다만 결과는 보낸 순서대로 처리해야 합니다.
blocking 연결에서도 사용할 수 있나?
사용 자체는 가능하지만, 공식 문서는 libpq pipeline mode를 non-blocking mode와 함께 쓰는 것이 좋다고 안내합니다. blocking mode에서는 클라이언트와 서버 사이에 deadlock이 생길 수 있기 때문입니다.
무조건 성능이 좋아지나?
그렇지 않습니다. pipeline mode는 네트워크 왕복 대기를 줄이는 기능입니다. 쿼리 실행 시간이 대부분을 차지하거나, 각 작업이 앞 작업 결과에 강하게 의존한다면 복잡도에 비해 이득이 작을 수 있습니다.
'프로그래밍 > 서버, DBMS' 카테고리의 다른 글
| Nginx HTTP/3 기준 (0) | 2026.09.22 |
|---|---|
| PostgreSQL WITHOUT OVERLAPS 기준 (0) | 2026.09.20 |
| PostgreSQL AIO 기준 (0) | 2026.09.18 |
| PostgreSQL uuidv7 기준 (1) | 2026.09.15 |
| PostgreSQL skip scan 기준 (0) | 2026.09.15 |